En los vídeos de demostración de redes sociales, ver programar a un agente de inteligencia artificial parece un truco de magia: alguien escribe una orden en lenguaje natural, el modelo vuelca sesenta líneas de código en diez segundos y todo funciona a la primera.
A raíz de ese espectáculo, no son pocos los programadores que afirman que el desarrollo guiado por pruebas (TDD) ya no tiene sentido: si una máquina genera o modifica código al instante y casi gratis, ¿para qué perder tiempo escribiendo tests antes de implementar?
La realidad en proyectos de software reales es justo la contraria. Cuanto más rápido y prolífico es un agente escribiendo código, más peligroso se vuelve si no trabaja encajonado dentro de una batería estricta de pruebas. Un programador humano que lleva tiempo en un proyecto posee contexto implícito: sabe que si toca un middleware para alterar una cabecera HTTP, puede afectar a la caché del servidor. Un modelo de lenguaje no tiene memoria histórica ni visión global: solo ve el fragmento de código que tiene delante y optimiza para que su encargo inmediato parezca resuelto.
En nuestro sistema, donde varios agentes de código resuelven tareas diarias sobre un motor compartido, el desarrollo guiado por pruebas no es una sugerencia metodológica: es la única razón por la que no rompemos producción cada tarde.
La regla de oro: un motor agnóstico y cero regresiones
Toda la infraestructura web de nuestros proyectos corre sobre un único motor agnóstico desarrollado en Laravel. Este núcleo interpreta manifiestos y colecciones declarativas para servir desde catálogos documentales con miles de páginas hasta herramientas interactivas y aplicaciones de gestión de tareas.
Esa arquitectura tiene una ventaja enorme: cualquier mejora que se programa en el núcleo beneficia de inmediato a todas las webs de la plataforma. Pero tiene un riesgo proporcional: cualquier descuido en una función común puede tumbar una docena de sitios distintos en un solo despliegue.
Por eso nos regimos por un principio no negociable: cero regresiones entre aplicaciones. El motor jamás incorpora una solución particular que arregle una web si eso degrada o modifica el comportamiento de otra.
Para sostener esa exigencia cuando el código lo escriben agentes, aplicamos el ciclo de TDD a rajatabla:
- Rojo (Red): antes de permitir que el agente toque una sola línea de lógica de negocio o de presentación, se escriben las pruebas unitarias y de integración que reproducen el problema o definen el nuevo contrato esperado. Los tests deben fallar de forma reproducible y con un mensaje de error limpio.
- Verde (Green): el agente recibe el encargo con las pruebas en rojo y los ficheros que puede editar. Su único objetivo es escribir la implementación más limpia posible para que esas pruebas pasen.
- Refactorización y comprobación global: una vez que los tests nuevos están en verde, no se hace commit. El orquestador ejecuta la suite completa de la plataforma antes de considerar que el trabajo es válido.
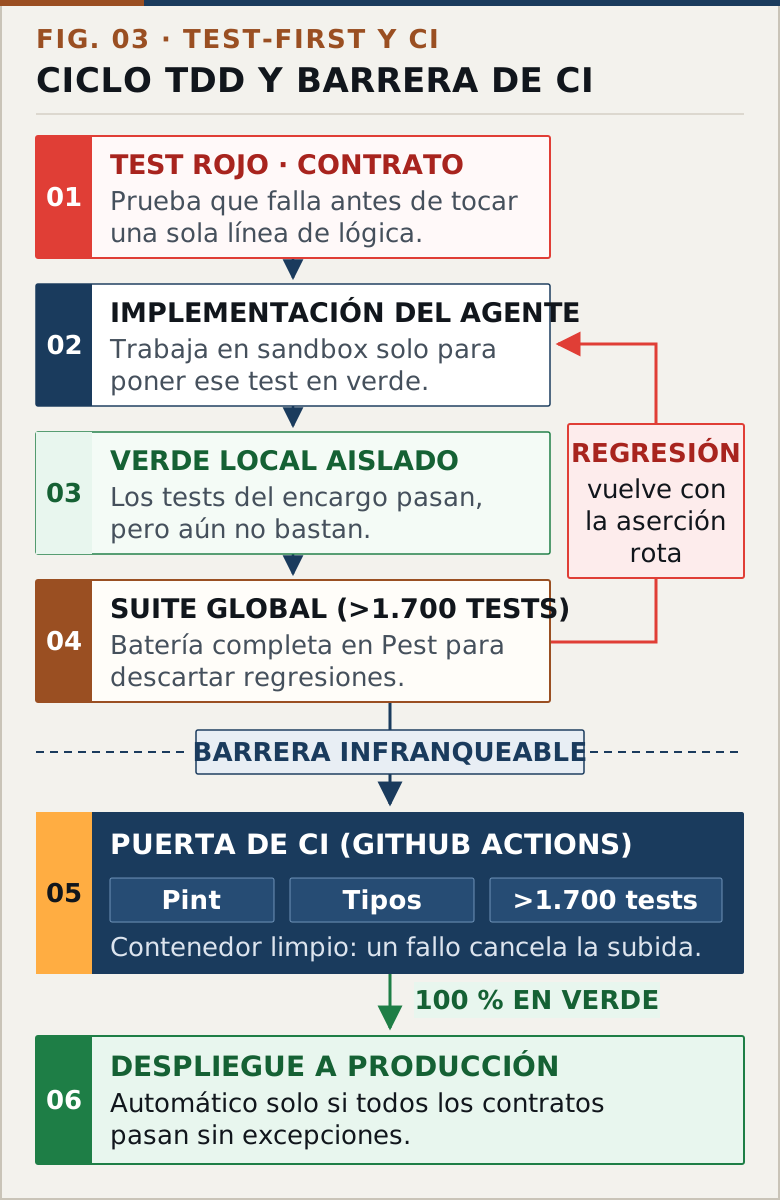 El ciclo de desarrollo guiado por pruebas: el agente solo implementa para que los tests pasen y el CI actúa como barrera infranqueable antes de producción.
La trampa de los quince tests en verde
Esta misma mañana vivimos en directo por qué fiarse del resumen de un agente es una garantía de desastre.
Teníamos que incorporar un mecanismo nuevo en el tratamiento de peticiones del motor. Encargamos la tarea a un agente de código que corre en un entorno aislado sin acceso a bases de datos reales ni a servidores externos.
El agente trabajó durante unos minutos, ejecutó sus propias comprobaciones y entregó un informe impecable: código implementado, quince pruebas unitarias nuevas añadidas a la batería de tests y todas pasando en verde resplandeciente. En su resumen explicaba con absoluta convicción que la funcionalidad estaba lista para desplegar.
Si nos hubiéramos fiado de ese informe, habríamos fusionado la rama de inmediato. Pero en nuestro flujo de trabajo, el orquestador tiene la obligación de pasar la suite completa del repositorio en el entorno local: más de 1.700 pruebas en Pest y Laravel que cubren contratos de arquitectura, componentes visuales, procesamiento de datos y endpoints de todas las aplicaciones.
El resultado al lanzar composer ci fue demoledor: la suite tronó con cuatro errores en rojo.
Los quince tests del agente estaban en verde, sí, pero estaban en verde porque evaluaban únicamente su nueva función en un vacío artificial. Al alterar la respuesta del controlador base para resolver su caso, el agente había desactivado sin querer la cabecera de caché en las respuestas del fichero robots.txt y en los índices de los sitemaps de todas las webs alojadas en el motor.
De haber llegado ese cambio a producción, cada petición recurrente de los rastreadores de Google o Bing habría golpeado de lleno a la aplicación PHP sin pasar por la caché, multiplicando la carga del servidor de forma absurda.
# La suite completa que destapó la regresión silenciosa
composer ci
# FAILED: 4 tests failed in Tests\Feature\SeoCacheHeadersTest
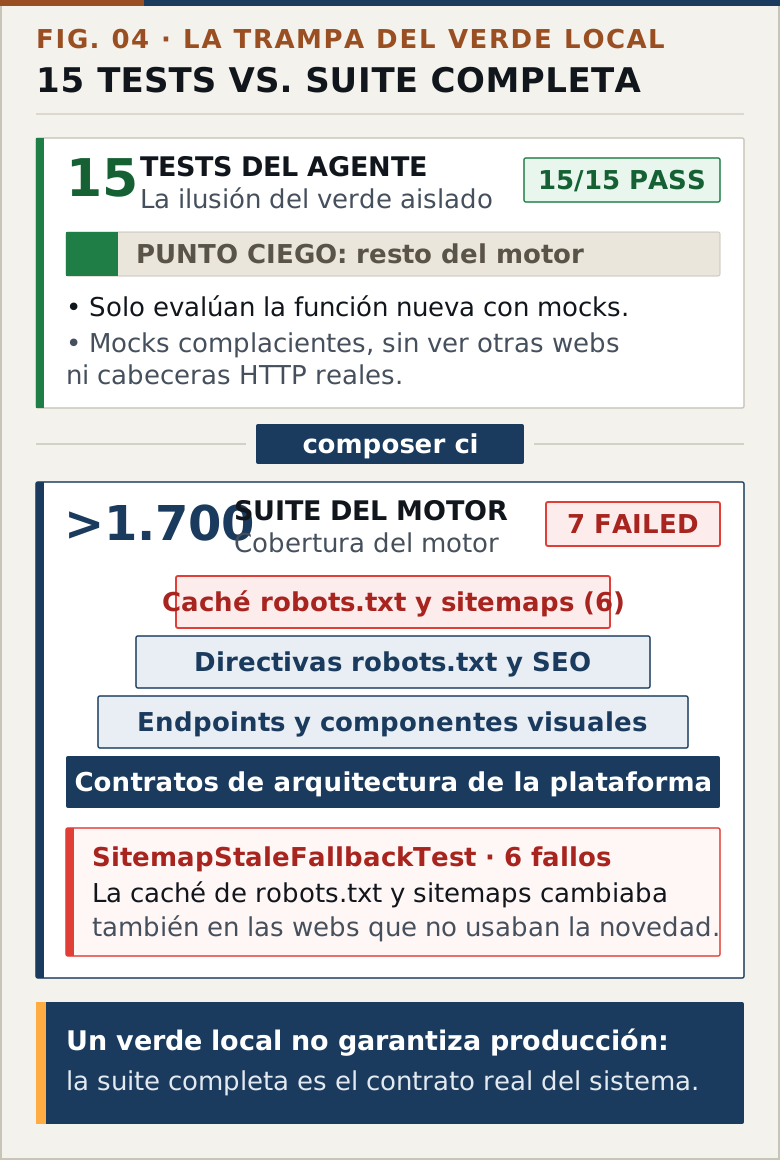 La trampa del verde local: 15 pruebas aisladas pasaban en el entorno del agente, pero la suite completa destapó cuatro regresiones críticas en la caché.
El bucle de corrección sin debates subjetivos
Tener una suite completa de pruebas transforma la relación con los agentes de código. Con humanos, una discusión sobre si un cambio es seguro o no suele derivar en debates de opinión, cansancio o exceso de confianza. Con un agente de IA, las opiniones no sirven de nada; los fallos exactos de los tests son la única moneda de cambio.
Cuando la suite saltó por los aires con los cuatro tests de caché rotos, no le pedí al agente que «tuviera más cuidado» ni le expliqué la teoría del problema.
Le devolví un encargo nuevo con los hechos exactos:
- El nombre de los cuatro tests que habían fallado.
- La ruta del fichero y la línea de aserción donde saltaba el error.
- El valor esperado (
Cache-Control: public, max-age=3600) y el valor recibido (Cache-Control: no-cache). - Una instrucción tajante: la funcionalidad nueva debe mantenerse, pero los tests existentes de la plataforma son un contrato inmutable y deben volver al verde sin alterar su comportamiento original.
El agente no protestó ni buscó justificaciones. Leyó la aserción rota, identificó la condición errónea en el middleware, ajustó la lógica para que solo afectara a las rutas de su encargo y en cinco minutos devolvió una corrección limpia. Al volver a lanzar la suite, los 1.700 tests pasaron en verde.
Ficheros residuales y mocks que mienten
En nuestro registro de incidencias técnicas acumulamos varias lecciones sobre cómo los agentes interactúan con los entornos de prueba:
- Tests que dependen de la basura de otros tests: en una ocasión, un agente escribió una prueba que pasaba siempre en la máquina de desarrollo pero fallaba de forma sistemática en el servidor de integración continua (CI). La razón era cómica: el test leía un fichero de caché en disco que había sido generado horas antes por otra prueba distinta. En local el fichero existía; en la máquina virtual limpia de GitHub Actions, el fichero no estaba y la prueba reventaba. Desde entonces, todo test debe usar fixtures versionados o crear y destruir sus propios datos en memoria.
- Mocks complacientes: si no vigilas al agente, tiende a escribir pruebas unitarias con mocks que imitan a la perfección sus propios supuestos erróneos. Puede entregarte sesenta tests en verde que validan una fantasía absoluta si la definición del mock no se ajusta milimétricamente a la respuesta real del servicio.
El CI como guardián final
En nuestro flujo nadie tiene permisos para entrar por SSH a un servidor y tocar ficheros en caliente. No hay despliegues manuales, ni parches de emergencia subidos con un cliente FTP, ni ramas fusionadas sin verificar.
La única puerta de entrada a producción es un flujo automatizado de integración continua en GitHub Actions. Cuando una rama recibe luz verde tras la revisión humana del diff, el CI ejecuta el análisis de formato con Pint, el análisis estático de tipos y la suite completa de más de 1.700 tests. Si un solo test falla, aunque sea por una coma o una cabecera de caché ausente, el despliegue se cancela en el acto y el servidor de producción sigue funcionando sin enterarse.
Un agente de inteligencia artificial es una herramienta extraordinaria para escribir código rápido, refactorizar patrones y desatascar tareas mecánicas. Pero no es un arquitecto de software ni tiene noción de responsabilidad operativa. Si quieres que los agentes programen en tu proyecto sin destruirlo, no confíes en sus promesas: ponles delante una batería implacable de tests y deja que sea la suite quien juzgue su trabajo.