Mantener varias webs pequeñas basadas en datos públicos tiene una trampa silenciosa: la escala. Cuando un catálogo o un buscador genera miles de páginas estructuradas a partir de registros abiertos, el SEO técnico deja de ser una lista de tareas que puedas revisar en una tarde de domingo.
Si intentas inspeccionar a mano las respuestas de servidor, los sitemaps de miles de registros, los enlaces canónicos o los errores de rastreo que dejan los buscadores, no te queda tiempo para programar. Pero si cometes el error de soltar a un modelo de lenguaje en tu repositorio con una orden vaga del tipo «analiza la web y optimiza el posicionamiento», el resultado es predecible: inventará palabras clave genéricas, reescribirá títulos claros con adjetivos rimbombantes y cambiará rutas indexadas sin mirar atrás.
En nuestro sistema de agentes (del que ya conté cómo diseñamos la arquitectura básica y los costes) abordamos el SEO como un problema de fontanería: telemetría en solo lectura, reglas inflexibles basadas en hechos y un bucle donde el agente solo toca lo que es seguro y documenta todo lo que aprende.
El colector: datos antes que opiniones
La primera regla del sistema es simple: ningún agente opina sobre el estado de una web si antes no ha recogido los datos. Los modelos de lenguaje tienden a rellenar huecos con optimismo infundado. Si un agente no ve errores evidentes a primera vista, asume que todo funciona de maravilla.
Para evitarlo, separamos la medición del análisis:
- Una rutina programada en segundo plano: un temporizador del sistema ejecuta cada pocas horas un script colector de solo lectura. De madrugada lanza una pasada completa que revisa la totalidad de los enlaces declarados en los sitemaps.
- Hechos tangibles, sin interpretación: el colector comprueba los códigos de estado HTTP reales de cada URL, las cabeceras
X-Robots-Tag, las etiquetas canónicas declaradas, las redirecciones intermedias y los errores 404 o 500 registrados en los accesos de los bots de búsqueda durante las últimas veinticuatro horas. - Integración con Search Console: la rutina extrae impresiones, clics, consultas en posiciones intermedias (lo que en el sector llaman distancia de disparo, entre la posición 8 y la 20) y el estado real de procesamiento de los sitemaps enviados.
El principio operativo que gobierna el proceso está escrito a fuego en las instrucciones del agente: sin dato no hay hallazgo. Si la API de Search Console no devuelve métricas porque la web tiene menos de dos semanas de vida, el agente tiene prohibido decir que el sitio «está sano». La falta de datos es simplemente ausencia de evidencia.
Autocorrección segura frente a tareas en el tablero
Una vez recopilada la telemetría, entra en juego el agente evaluador. Su trabajo no es redactar informes floridos para que nadie los lea, sino tomar decisiones en función de dos niveles de riesgo muy claros:
1. Autocorrección segura (intervención directa)
Hay problemas mecánicos donde la solución es unívoca, está probada y no requiere debate editorial. En esos casos, el agente tiene autorización para aplicar la corrección directamente en la configuración de la web mediante la CLI del motor:
- URLs eliminadas que devuelven 404: cuando un registro desaparece de una base de datos pública y el buscador sigue intentando rastrearlo, cada petición fallida consume presupuesto de rastreo. Si el agente detecta que Googlebot insiste con URLs obsoletas, las añade a la lista de rutas con respuesta
410 Gone. Al recibir un 410, el buscador entiende de inmediato que el recurso desapareció para siempre y lo retira de su índice sin volver a insistir. - Puertas de indexación para páginas escasas: si un catálogo o un filtro temático agrupa menos de un número mínimo de registros (por ejemplo, menos de tres elementos en una provincia o categoría), indexarlo es contraproducente porque los motores lo consideran contenido delgado (thin content). El agente ajusta la condición para que esas páginas se sirvan con directiva
noindex, followy salgan del sitemap, preservando el flujo de enlaces internos sin saturar el índice. - Ajustes de títulos en posiciones cercanas: cuando una consulta real acumula muchas impresiones en segunda página pero el título de la página corta el término principal o lo relega al final, el agente reordena la plantilla para que la entidad buscada aparezca en los primeros 50 caracteres.
Toda acción aplicada se publica inmediatamente con su versión correspondiente y queda documentada en el informe de cierre.
2. Tareas en el tablero (lo que requiere criterio humano)
Cualquier cambio estructural, rediseño de URLs, caídas bruscas de impresiones que no tengan una causa técnica evidente o discrepancias entre la canónica declarada y la elegida por el buscador se consideran incidencias.
El agente no inventa parches ni altera el código del motor. Lo que hace es redactar una tarea concreta con la evidencia técnica (URL, código HTTP, consulta e impresión) y la asigna a mi tablero de proyectos.
# Ejemplo del comando que corre la rutina en modo de prueba
rutinas run seo --dry-run
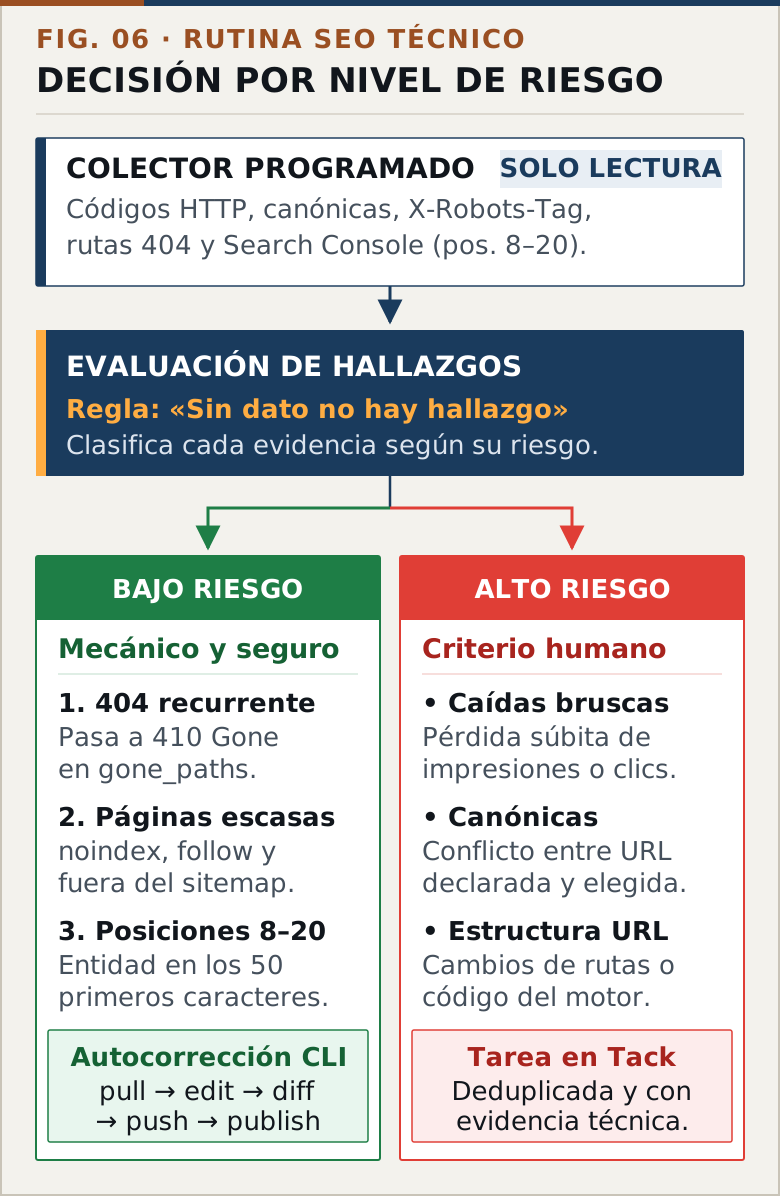 Flujo de la rutina de SEO técnico: la telemetría objetiva alimenta al agente, que autocorrige incidencias mecánicas o escala tareas deduplicadas al tablero.
El día que casi inundamos el gestor de tareas
La teoría suena ordenada, pero al principio cometimos un error de bulto en la automatización.
Configuramos la rutina para ejecutarse cada cuatro horas. Un fin de semana modificamos la estructura de un catálogo y unas cincuenta URLs antiguas empezaron a responder con error 404 antes de que pudiéramos redirigirlas.
El colector hizo su trabajo: detectó las cincuenta URLs y el agente generó cincuenta hallazgos. Como no habíamos previsto un mecanismo de memoria a corto plazo, cuatro horas después la rutina volvió a correr, encontró los mismos cincuenta errores y creó otras cincuenta tareas.
Para el lunes por la mañana, el tablero tenía más de seiscientas tareas idénticas acumuladas. El sistema se había convertido en un generador de ruido insoportable.
La solución fue incorporar deduplicación obligatoria contra el estado vivo del gestor de proyectos: antes de crear una tarea, la rutina comprueba si ya existe una tarea abierta con el mismo título y asignada a la misma persona. Si ya existe, simplemente enlaza la evidencia al informe de esa ejecución y no genera registros duplicados. Parece una obviedad, pero en sistemas automatizados con agentes, si no programas la deduplicación de forma explícita, el entusiasmo del modelo te sepulta.
Habilidades con registro de aprendizaje
El mayor problema de los agentes no es que cometan errores, sino que cometan el mismo fallo en cada ejecución porque su memoria se borra al cerrar el proceso.
Para resolverlo, cada habilidad especializada (skill) que cargan nuestros agentes incluye al final un registro de aprendizaje: una tabla Markdown en el propio fichero de instrucciones donde anotamos cada lección aprendida con fecha, web afectada, situación previa, solución y regla derivada.
| Fecha | Cambio | Web | Antes | Después | Lección |
|---|---|---|---|---|---|
| 16-nov | Muestra de títulos | datos | 18 % títulos <40 car. | — | Medir títulos con muestra amplia; no fiarse de 2 URLs. |
| 17-nov | Auditoría sitemaps | datos | 70+ URLs en 404 | gone_paths (410) | Convertir 404s viejos a 410 libera rastreo de inmediato. |
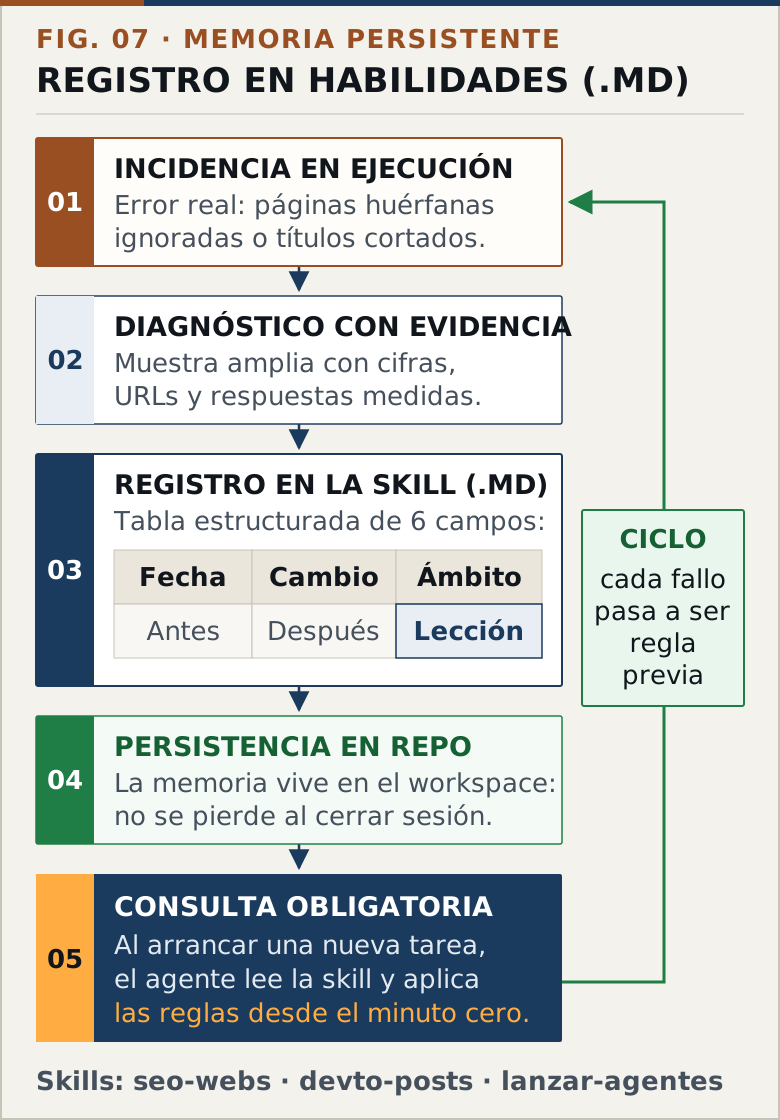 El registro de aprendizaje en cada habilidad: cada incidencia se documenta con su evidencia y se convierte en regla previa para futuras ejecuciones.
Cuando un agente tropieza con un caso nuevo, esa experiencia no se queda en un chat efímero. Si descubrimos que en un dominio nuevo Googlebot ignora por completo miles de páginas de fichas individuales hasta que los hubs temáticos tienen autoridad y enlaces externos, esa conclusión se añade a la tabla de la habilidad.
La próxima vez que el agente se despierta para auditar un lanzamiento, lee su propia habilidad y sabe de antemano que no debe intentar indexar miles de páginas huérfanas de golpe. Las reglas dejan de ser dogmas teóricos y se convierten en un registro histórico de cicatrices técnicas.
El SEO con agentes no consiste en pedirle a un modelo que escriba textos de relleno ni en buscar atajos milagrosos. Consiste en medir con precisión milimétrica, dejar que la máquina resuelva la fontanería repetitiva con reglas estrictas y asegurar que cada tropiezo quede anotado para que no vuelva a ocurrir jamás.