Trabajo como desarrollador full stack en Valladolid desde 2018. Por el día tengo mi empleo por cuenta ajena; por las tardes y fines de semana construyo proyectos propios bajo la marca Devetty: microapps, scrapers, automatizaciones y agentes de software.
Si abres Twitter o LinkedIn, parece que el mundo se gestiona solo. Cuentas con tres semanas de vida explican cómo facturan seis cifras mientras duermen gracias a enjambres de agentes que debaten entre sí en una sala virtual.
En el software real la historia es otra. Si dejas a un agente suelto en tu repositorio con una tarjeta vinculada y orden de «crear valor», lo normal es que gaste cincuenta euros en razonamiento profundo, entre en bucle infinito en el gestor de paquetes y borre la mitad de tus tests mientras redacta un README impecable explicando su éxito rotundo.
Por eso montamos nuestro propio sistema: sin autonomía mágica, supervisado por un humano y con los costes atados en corto.
La idea central: orquestar en vez de dejar libre
El principio de partida es simple: no hay agentes autónomos. Ninguno decide qué tarea abordar, ni habla con otros agentes en un canal abierto, ni despliega nada a producción por su cuenta.
La estructura se apoya en tres piezas:
- Un orquestador que piensa y revisa. La sesión principal donde analizo problemas, diseño la solución técnica, redacto los encargos y reviso cada línea de diff antes de tocar una rama principal.
- Un tablero de tareas. Usamos nuestro gestor de proyectos (Tack). Cada encargo nace de una tarea concreta, registra avances en comentarios y se cierra cuando la solución está probada.
- Agentes ejecutores especializados. En vez de un modelo mastodóntico que intente saber de todo, tenemos tres perfiles con límites estrictos:
- Dani: código. Modifica solo los ficheros necesarios, añade tests y no puede hacer commit ni tocar bases de datos reales.
- Dora: diseño y maquetación. Piensa en quien entra desde el móvil buscando un dato rápido: jerarquía visual, tipografía legible y que la interfaz no estorbe.
- Gala: crecimiento y contenido. Analiza la indexación técnica en buscadores, detecta páginas huérfanas y redacta borradores directos, sin relleno.
Separamos además personalidad de habilidad (skill). La personalidad define quién es el agente y sus límites de seguridad. La habilidad es conocimiento acumulado que se carga bajo demanda. Si aprendemos que una librería de fechas devuelve negativos al restar marcas de tiempo pasadas, esa lección se añade a la habilidad correspondiente para que ningún agente tropiece dos veces con la misma piedra.
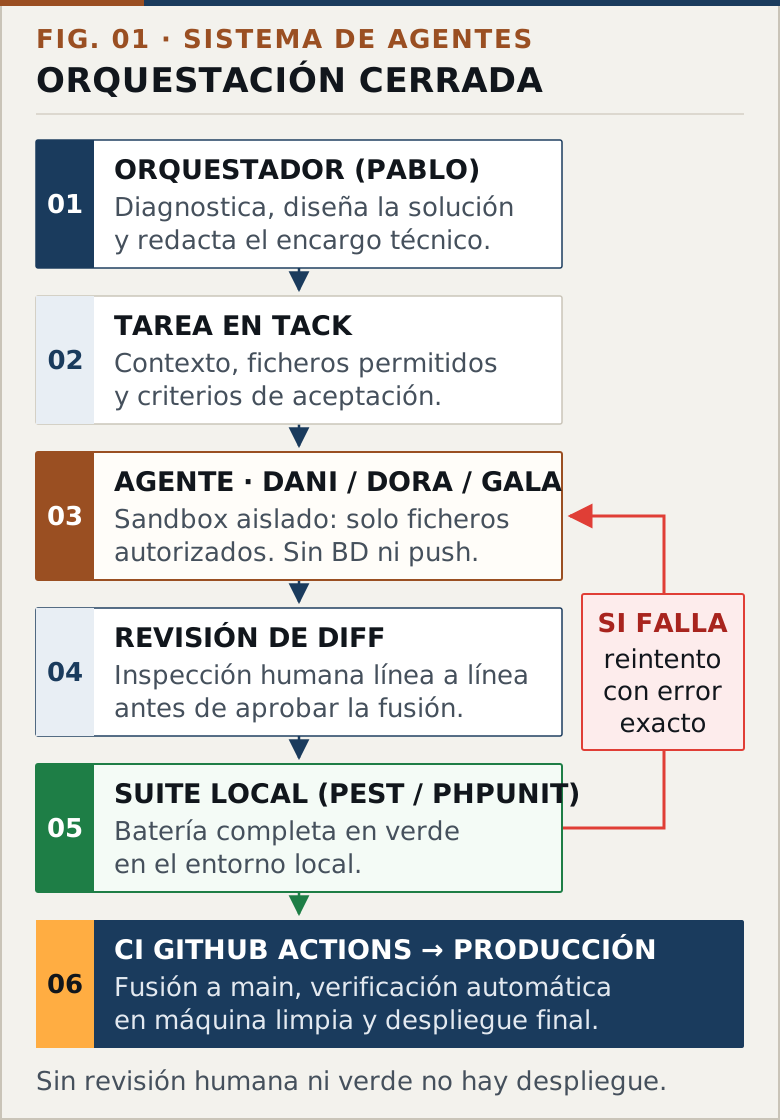 Flujo de orquestación cerrada: el orquestador define la tarea en Tack, el agente ejecuta en sandbox, y el diff se valida con tests antes de llegar a la rama principal.
Mirar el céntimo: modelos por niveles
El peligro con los modelos de lenguaje no es que alucinen, sino la factura a fin de mes. Usar el modelo más caro del mercado para mover un botón en un CSS es contratar a un arquitecto municipal para cambiar una bombilla.
Organizamos los modelos en tres niveles de esfuerzo:
- Pequeño (
small): cambios triviales de uno o dos ficheros, pequeños ajustes de texto o sintaxis. Usamos modelos ultraligeros o gratuitos incluidos en las herramientas. - Mediano (
medium): el tamaño habitual para maquetación, redacción o refactorizaciones controladas. - Grande (
large): reservado para cambios arquitectónicos, migraciones delicadas o razonamiento profundo.
Un script lanzador automatiza la elección. Cada nivel tiene su lista ordenada de modelos, del más barato al más costoso. Antes de lanzar, consulta en tiempo real las cuotas de cada proveedor y elige el primero disponible que no esté saturado.
# Lanzar un encargo de código con Dani en nivel medio
agente dani --size medium "Corregir paginación en el listado"
El lanzador tiene una regla inmutable: si el modelo falla en el primer minuto por saturación o límites de cuota (error 429), reintenta con el siguiente del mismo nivel. Jamás sube de nivel por su cuenta. Si la lista se agota, se detiene y avisa. Preferimos esperar diez minutos a que una herramienta queme saldo sin permiso.
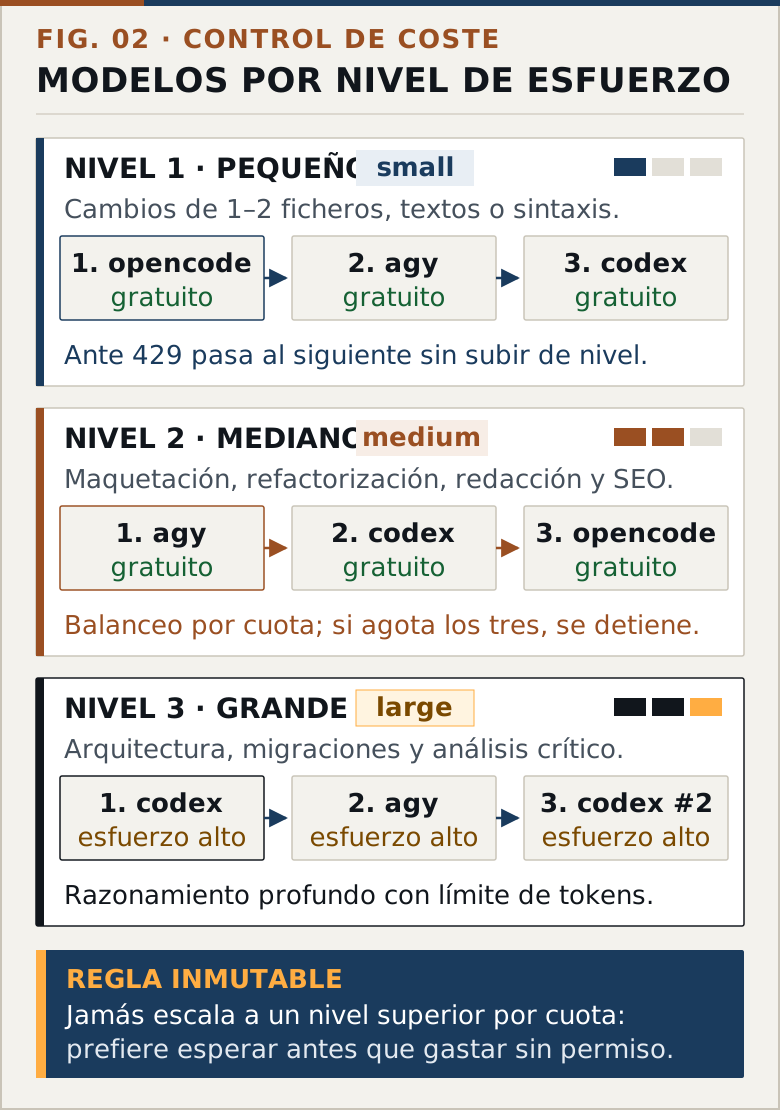 Estructura de modelos por niveles: orden de prioridad del más económico al más avanzado según la complejidad y cuotas en tiempo real.
Además, cada ejecución guarda el prompt exacto, el log en bruto, el resumen final y el modelo usado. Si algo falla, es totalmente reproducible.
Anécdotas del barro: cuando la teoría tropieza
Todo suena razonable en el diagrama. En el día a día, construir este sistema ha sido una serie continua de tropiezos. En nuestro registro interno anotamos cada incidencia para no repetirla. Estas tres resumen bien el panorama:
1. Veinte minutos esperando la nada
Al principio ejecutábamos herramientas en segundo plano para seguir trabajando en la terminal. Un día lanzamos un agente con Codex para un cambio menor. Pasaron cinco, diez, quince minutos. El proceso seguía vivo, consumiendo cero procesador y sin escribir un solo byte de log.
¿Estaba razonando una arquitectura cuántica? No. La herramienta esperaba entrada por teclado (Reading additional input from stdin...). Al correr desatendida sin redirigir la entrada estándar (< /dev/null), se quedó esperando a que alguien pulsara Enter en un terminal invisible. Veinte minutos congelado por un despiste en Bash.
2. Sesenta y tres tests en verde sobre una mentira
Esta dolió porque la culpa fue mía. Necesitábamos una utilidad para auditar páginas de datos. Redacté el encargo describiendo la API de memoria, olvidando un parámetro clave en la ruta del endpoint.
El agente fue impecable. Escribió el código, creó mocks imitando al milímetro mi descripción y pasó 63 tests en verde resplandeciente.
Al probar la herramienta contra el servicio real: cero páginas procesadas. El código era perfecto contra la ficción que le conté; contra la realidad, inútil. La lección fue clara: los agentes replican tus errores con precisión matemática. Si partes de una premisa falsa, te entregan un fracaso perfectamente verificado.
3. El mock que casi devora la máquina
En otra ocasión, un agente debía programar una función con paginación por lotes y sus pruebas. Para validar la lógica, escribió un mock que simulaba la respuesta del servidor.
El detalle: configuró el mock para que siempre indicara que quedaba una página siguiente. Al ejecutar la suite, el bucle no terminó nunca. En noventa segundos acumuló casi nueve gigabytes de RAM hasta que el sistema operativo empezó a congelarse y el recolector de procesos tuvo que intervenir para que el equipo no colapsara. Desde entonces, toda suite lanzada por un agente corre con límites estrictos de memoria y tiempo.
Qué viene ahora
No creo en el software que se programa solo ni en agentes que sustituyen el criterio técnico. Los modelos de lenguaje son excelentes ejecutores: rápidos para tareas mecánicas, incansables y útiles para contrastar código o estructurar datos. Pero necesitan raíles estrechos, límites de gasto estrictos y un ojo humano que revise cada coma.
Lo siguiente que queremos probar en el workspace es automatizar evaluaciones a ciegas para cambios visuales antes de fusionar ramas y ajustar todavía más los presupuestos de tokens por tarea. Poco a poco, sin prisas y sin quemar saldo a lo tonto.