Abres la consola del servidor para revisar el almacenamiento de la base de datos relacional y te encuentras con una cifra desconcertante: una tabla de caché supera los tres gigabytes en disco y acumula cientos de miles de filas que ya no sirven para nada.
Habías configurado el driver de base de datos en Laravel para almacenar respuestas temporales y consultas pesadas dentro de nuestras aplicaciones bajo la marca Devetty. En cada operación guardabas los datos con un tiempo de vida explícito: unas horas para una consulta agregada, unos minutos para un fragmento HTML.
La suposición natural cuando empiezas a trabajar con un framework de este nivel es que el propio sistema se encarga de retirar lo que caduca. Sin embargo, en las bases de datos relacionales la realidad operativa es muy distinta.
La trampa de la expiración pasiva
Para entender por qué se acumulan millones de filas muertas, conviene mirar cómo implementa Laravel su driver de caché sobre bases de datos relacionales.
La tabla estándar que genera la migración contiene tres columnas fundamentales: la clave (key), el contenido serializado (value) y una marca de tiempo con el segundo exacto en que expira el registro (expiration).
Cuando la aplicación solicita una clave mediante Cache::get(), el framework ejecuta una consulta sencilla buscando el registro por su clave. Al recuperar la fila, comprueba si la marca de tiempo de expiración es inferior al instante actual. Si el registro ya ha caducado, devuelve un valor nulo, exactamente igual que si la clave nunca hubiera existido.
El detalle crítico está en lo que el framework no hace: no ejecuta un comando de eliminación sobre esa fila caducada.
Hacerlo en cada lectura sería una pésima decisión arquitectónica. Si cada vez que un usuario consulta una clave caducada el servidor lanzara una sentencia de borrado, convertiríamos operaciones de lectura en operaciones de escritura. Eso introduciría bloqueos de fila, saturaría el registro transaccional y degradaría el rendimiento de las consultas concurrentes bajo tráfico real.
Por su parte, cuando guardas un dato nuevo mediante Cache::put(), el framework inserta la clave o actualiza su valor si ya existe. En ningún momento realiza un escaneo de la tabla para limpiar claves antiguas que pertenezcan a otras operaciones.
El resultado es un sistema de expiración puramente pasiva: para la aplicación el dato está muerto porque nunca lo devolverá, pero en el motor de almacenamiento de la base de datos la fila permanece ocupando espacio de forma indefinida.
El error del borrado masivo sin límites
Cuando descubres que tu tabla contiene quinientas mil filas caducadas y varios gigabytes obsoletos, la primera tentación es ejecutar una sentencia directa para vaciar la basura acumulada:
DELETE FROM cache WHERE expiration < UNIX_TIMESTAMP();
Ejecutar esa instrucción en un entorno de producción activo es una de las formas más rápidas de provocar una caída del servicio.
Una sentencia de eliminación masiva sobre cientos de miles de registros obliga al motor de base de datos a abrir una transacción de dimensiones enormes. Durante la ejecución, el motor adquiere bloqueos exclusivos sobre rangos de índices y páginas de datos para garantizar la coherencia transaccional. Además, debe escribir cada fila modificada en el registro de reversión (undo log) por si la operación falla a mitad de camino.
El impacto sobre el servidor es demoledor:
- Bloqueo de consultas concurrentes: cualquier petición entrante que intente leer o actualizar la tabla de caché quedará en cola esperando a que termine el borrado masivo.
- Agotamiento del grupo de conexiones: los procesos de PHP en el servidor web se acumulan esperando respuesta de la base de datos hasta alcanzar el límite máximo de trabajadores concurrentes.
- Pico de lectura y escritura en disco: el trasvase masivo de páginas de memoria hacia los registros de transacción satura el ancho de banda del almacenamiento.
- Errores en cascada para los usuarios: el servidor web empieza a devolver errores de tiempo de espera agotado (códigos 504) o fallos de pasarela (códigos 502) porque las peticiones no pueden completarse a tiempo.
Una operación de limpieza diseñada para mejorar la salud del sistema termina convirtiéndose en el motivo principal de una interrupción de servicio.
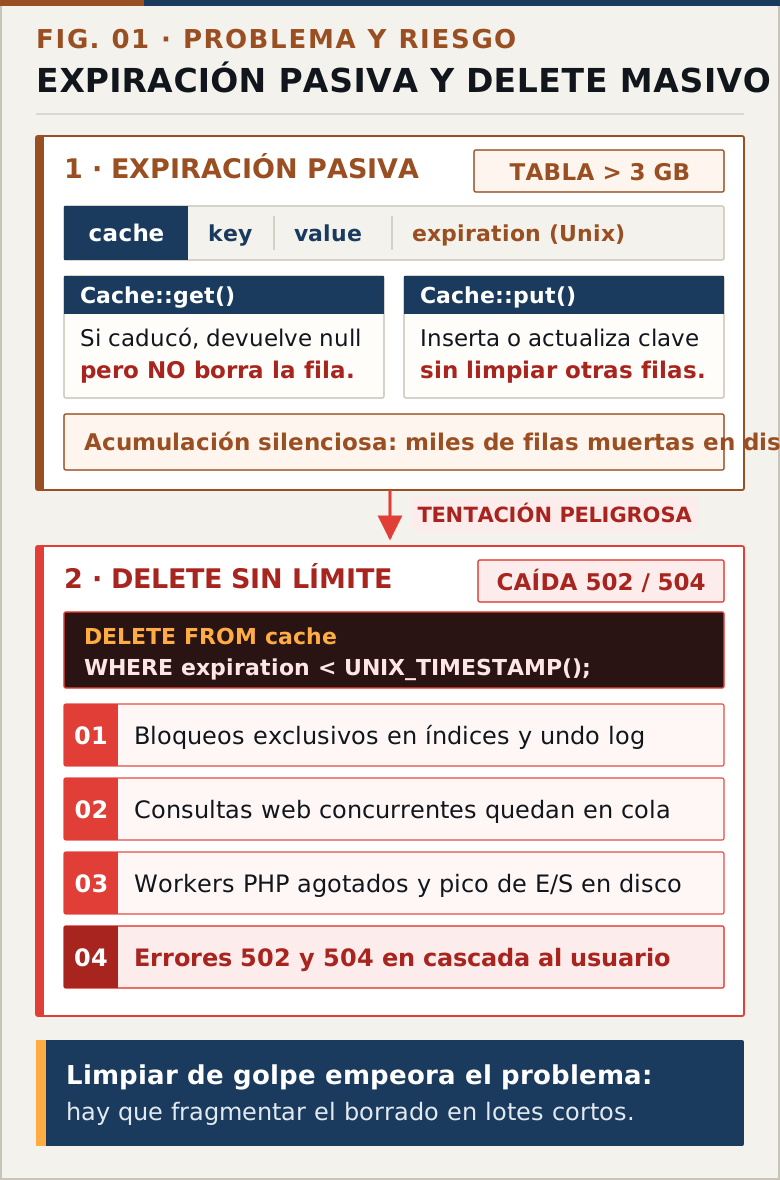 Por qué se acumulan filas caducadas en disco y cómo un borrado masivo sin límite bloquea la tabla hasta causar errores 502 y 504.
La solución: poda por lotes pequeños con clave primaria
Para evitar bloqueos prolongados y mantener la base de datos perfectamente receptiva durante las tareas de mantenimiento, la solución pasa por fragmentar la limpieza en lotes pequeños y predecibles.
El principio técnico es directo: en lugar de pedirle a la base de datos que borre todo lo caducado de golpe, seleccionamos un número limitado de claves expiradas (por ejemplo, mil elementos), borramos exclusivamente ese lote por su clave primaria y repetimos el ciclo hasta agotar los registros pendientes.
Implementamos esta lógica en un comando de mantenimiento personalizado dentro de nuestro planificador:
$pruneTable = function (?string $conn, string $tbl) use ($now, $batchSize): int {
    if (! Schema::connection($conn)->hasTable($tbl)) {
        return 0;
    }

    $totalDeleted = 0;

    do {
        $keys = DB::connection($conn)
            ->table($tbl)
            ->where('expiration', '<', $now)
            ->limit($batchSize)
            ->pluck('key');

        if ($keys->isEmpty()) {
            break;
        }

        $deleted = DB::connection($conn)
            ->table($tbl)
            ->whereIn('key', $keys)
            ->delete();

        $totalDeleted += $deleted;
    } while ($deleted > 0 && $keys->count() >= $batchSize);

    return $totalDeleted;
};
Este diseño ofrece tres ventajas determinantes para la estabilidad del servidor:
- Transacciones cortas y atómicas: borrar mil claves por su identificador primario tarda escasos milisegundos. El motor de almacenamiento adquiere bloqueos breves y los libera de inmediato.
- Concurrencia transparente: entre la finalización de un lote y el inicio del siguiente, el motor de la base de datos puede atender consultas de lectura y escritura de las peticiones web ordinarias sin encolarlas.
- Consumo de memoria constante: el script solo carga en memoria la lista de identificadores del lote actual, sin importar cuántas filas queden por depurar en la tabla.
Además de la tabla principal de caché, aplicamos la misma rutina sobre la tabla auxiliar de bloqueos temporales (cache_locks), garantizando que los bloqueos atómicos abandonados por procesos interrumpidos no queden huérfanos.
Pruebas automatizadas y programación segura
Siguiendo la disciplina de probar el comportamiento antes de dar por buena una solución, escribimos pruebas automatizadas con Pest para blindar el comando ante casos límite:
- Verificamos que las claves con expiración futura permanecen intactas tras la ejecución.
- Comprobamos que las claves con expiración pasada se eliminan de forma efectiva.
- Validamos que el bucle se detiene correctamente cuando el número de filas caducadas es menor que el tamaño del lote.
- Confirmamos que una tabla vacía no produce advertencias ni excepciones inesperadas.
Una vez probado, registramos la llamada en el programador de tareas del framework asegurando que nunca se solapen dos ejecuciones:
Schedule::command('cache:prune-expired')->daily()->withoutOverlapping();
La directiva de evitar solapamiento es esencial: si por una acumulación extraordinaria de trabajo el comando tarda más de lo previsto, el programador esperará a que concluya antes de permitir una nueva ejecución, evitando que dos procesos compitan por borrar los mismos registros.
Esta disciplina de mantenimiento preventivo es la misma que aplicamos en Tack para asegurar que el registro de eventos y métricas mantenga tiempos de respuesta estables a lo largo de los meses.
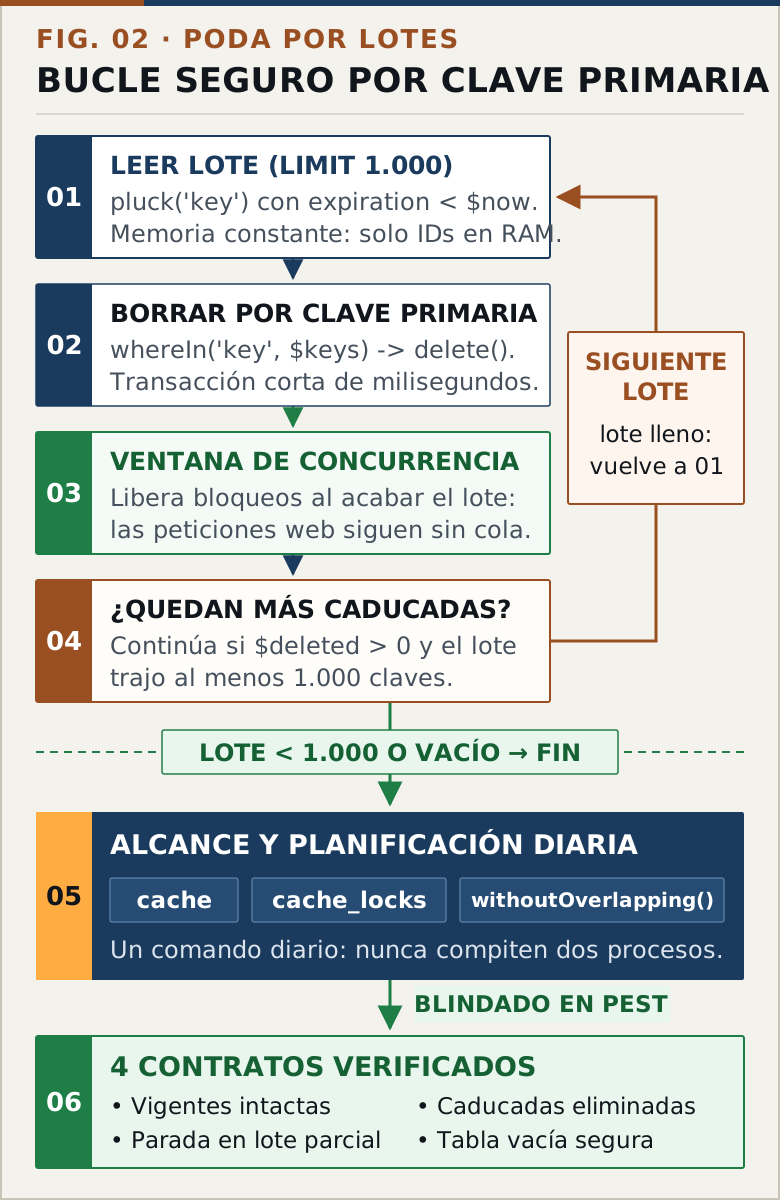 Flujo completo de la poda por lotes: transacciones cortas por clave primaria, concurrencia entre bloques y ejecución diaria blindada en Pest.
Criterios para una caché relacional saludable
Utilizar la base de datos relacional como almacén de caché es una alternativa práctica para proyectos pequeños y medianos porque ahorra la complejidad de gestionar servicios dedicados adicionales. Pero exige una gestión consciente del almacenamiento:
- Define siempre tiempos de expiración finitos. Evita almacenar elementos con duración indefinida a menos que dispongas de una clave de invalidación explícita en tu lógica de negocio.
- Programa podas periódicas por lotes. No esperes a que el disco alcance el límite de capacidad para limpiar registros caducados; automatiza la poda diaria en horarios de baja actividad.
- Nunca ejecutes borrados masivos sin cláusula de límite. Cualquier operación de mantenimiento sobre tablas con alta concurrencia debe estructurarse en bloques pequeños para no secuestrar los bloqueos del motor transaccional.
- Vigila el tamaño físico de las tablas. El número de filas no es el único indicador relevante: supervisa periódicamente el espacio consumido por los índices para asegurar que las consultas sigan resolviéndose en memoria principal.
Una arquitectura de software sostenible no solo consiste en escribir código que funcione al desplegar, sino en diseñar los mecanismos de limpieza que evitan que el sistema se ahogue bajo su propio peso con el paso de las semanas.